Leistung
In ChatGPT, Perplexity und Googles KI-Antworten genannt werden.
Immer mehr Menschen fragen einen Assistenten statt eine Suchmaschine. Der antwortet aus dem, was er über Ihren Betrieb lesen kann. Ich sorge dafür, dass er es lesen darf, dass es eindeutig ist und dass es mit Ihrem Impressum übereinstimmt.
- Grundlage
- Dieselbe wie für Google
- Auf wemodo.de umgesetzt
- llms.txt, Content-Signale, eine Entität
- Garantierte Nennung
- keine
Woher ein Assistent über Sie weiß.
Ein Sprachmodell kennt Ihren Betrieb aus zwei Quellen. Aus dem, was beim Training im Netz stand, und aus dem, was es zur Laufzeit nachschlägt: über einen Suchindex oder einen eigenen Crawler. Für eine aktuelle Frage wie „guter Fahrdienst in Burgau“ zählt fast immer die zweite Quelle. Was dort nicht lesbar ist, kommt in der Antwort nicht vor.
- Ihre Website, sofern deren Crawler sie lesen dürfen
- Suchindizes, aus denen Assistenten ihre Treffer beziehen
- Drittseiten: Branchenverzeichnisse, Bewertungen, Presse, Verbände
- Ihr Google-Unternehmensprofil für Googles eigene KI-Antworten
Was ich an Ihrer Seite einrichte.
Fast alles davon hilft gleichzeitig bei Google. Es ist keine zweite Optimierung neben der ersten, sondern dieselbe, nur ernster genommen.
-
robots.txt, die Such- und Antwort-Crawler zulässt und das Training ausdrücklich regelt
-
Ein Unternehmensknoten mit fester Kennung, auf den jede Seite verweist
-
Eine llms.txt, die in einem Abruf sagt, welche Seite welche Frage beantwortet
-
Texte, die die Antwort zuerst geben und die Begründung danach
Woran Assistenten scheitern.
Am häufigsten an Widersprüchen. Die frühere Framer-Fassung von wemodo.de nannte in ihren strukturierten Daten einen Sitz in München, im Impressum stand Burgau. Ein Mensch überliest das. Ein Modell, das beide Angaben findet, muss raten, und eine geratene Antwort nennt im Zweifel lieber einen anderen Betrieb.
Unterschiedliche Adressen oder Telefonnummern auf Website, Profil und Verzeichnissen
Wichtige Angaben nur in Bildern oder PDF-Dateien
Eine robots.txt, die Crawler pauschal aussperrt
Seiten, die nur aus Werbesätzen bestehen und keine Frage beantworten
Was sich nicht einrichten lässt.
Ob ein Assistent Sie nennt, entscheidet sein Betreiber, und die Regeln dafür ändern sich ohne Ankündigung. Erwähnungen auf anderen Seiten, Bewertungen und Verlinkungen wachsen mit der Zeit und mit Ihrer Arbeit. Ich sorge dafür, dass alles, was auf Ihrer Seite liegt, gelesen werden kann und stimmt. Eine Nennung verspreche ich nicht.
Beleg
Ein Auftritt, den Sie nachprüfen können.
Erreichbar, im Tagesbetrieb und in zehn Sekunden selbst nachmessbar.
Finanzberatung, Region
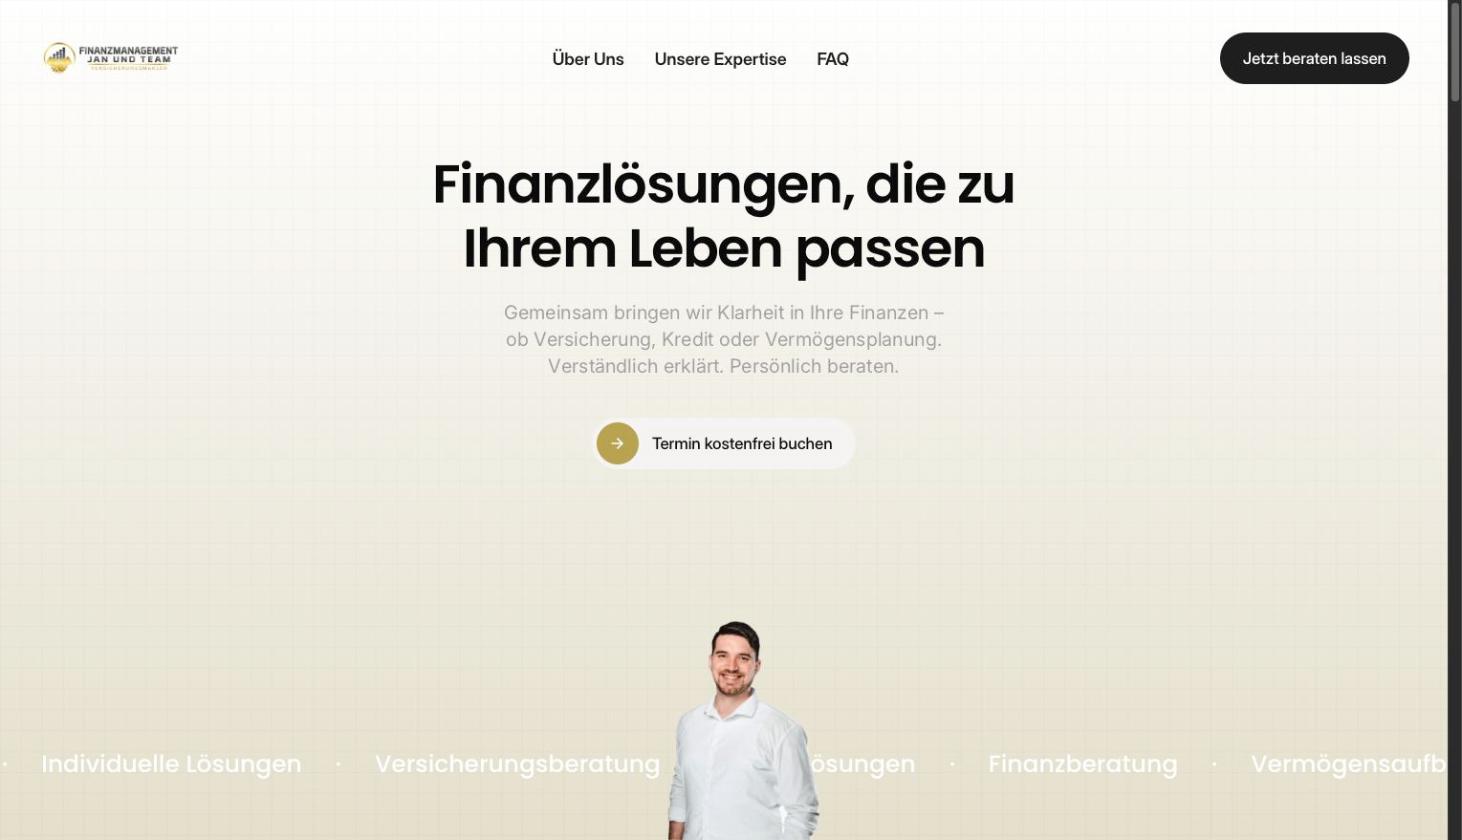
Eine Finanzberatung, die erklärt, statt nur Termine anzubieten.
Ratgeber
Zum Thema nachlesen.
In ChatGPT gefunden werden: was ein Betrieb dafür tun kann
In ChatGPT, Perplexity und Googles KI-Übersicht gefunden werden: welche Crawler Sie zulassen, was auf die Seite gehört und was niemand versprechen kann.llms.txt erklärt: was die Datei kann und was nicht
Was ist eine llms.txt? Aufbau, Beispiel von wemodo.de, Unterschied zu robots.txt und Sitemap, und warum sie kein Standard ist, den alle KI-Anbieter lesen.Strukturierte Daten für kleine Betriebe: welches Schema Sie wirklich brauchen
Strukturierte Daten nach schema.org für kleine Betriebe: LocalBusiness, Service mit Einzugsgebiet, BreadcrumbList, @id und was aus FAQPage geworden ist.
Was vorher geklärt sein sollte.
Ihre Frage fehlt? Schreiben Sie mir, ich antworte selbst.
Frage stellenWas ist GEO?
GEO steht für Generative Engine Optimization: eine Website so aufzubauen, dass Sprachmodelle sie finden, lesen und als Quelle verwenden können. Die Grundlagen sind dieselben wie bei der Suchmaschinenoptimierung. Der Unterschied liegt in der Gewichtung: eindeutige Fakten, klare Antworten und widerspruchsfreie Angaben zählen noch mehr.
Kann ich verhindern, dass mit meinen Texten KI trainiert wird?
Teilweise. Die großen Anbieter benennen eigene Crawler für das Training, die sich in der robots.txt aussperren lassen, getrennt von denen für Suche und Antworten. Dazu kommt ein Content-Signal mit dem Vorbehalt gegen Training nach EU-Urheberrecht. Auf wemodo.de steht genau das: Suche und Antworten ja, Training nein.
Brauche ich dafür eine neue Website?
Meistens nicht. robots.txt, llms.txt und strukturierte Daten lassen sich an fast jeder Seite ergänzen. Eine neue Seite lohnt sich erst, wenn die bestehende keine Fragen beantwortet oder ihre Inhalte nur als Bild oder PDF vorliegen.
Woran sehe ich, ob mein Betrieb in KI-Antworten vorkommt?
Am einfachsten, indem Sie die Fragen stellen, die Ihre Kunden stellen würden, in mehreren Assistenten. Klickt jemand in einer Antwort auf Ihre Seite, erscheint der Assistent in der Auswertung als Herkunft, etwa chatgpt.com oder perplexity.ai. Eine Liste aller Nennungen gibt es nicht.
Kontakt
Erzählen Sie mir von Ihrem Projekt.
Website, Relaunch, Software oder App: Füllen Sie die Lücken aus, der Rest ist ein kurzer Brief. Das Erstgespräch ist unverbindlich.
Ich antworte werktags innerhalb von 24 Stunden, selbst und ohne Textbaustein. Im ersten Gespräch sehe ich mir Ihren Auftritt an und sage, was ich zuerst ändern würde, auch wenn Sie danach nicht mit Wemodo arbeiten.
Danach wissen Sie, was das Projekt kostet und wie lange es dauert.
An Enver Eser Wemodo · Burgau